音声認識70年史。技術はどのように進化してきたのか
「話した言葉が、そのまま文字になる」
いまでは当たり前になりつつある音声認識。
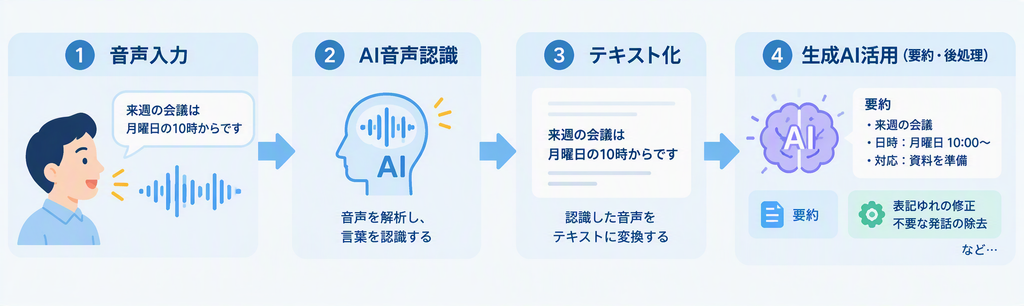
会議では発言をリアルタイムで文字起こしし、AIが議事録を自動でまとめる。インタビューでは録音した音声からテキストを作成し、コールセンターでは会話をリアルタイムで分析する。さらに生成AIと組み合わせれば、音声から要約や報告書、タスクまで自動で作成できるようになりました。
2026年、音声認識は「話した言葉を文字にする技術」から、人の声を起点に情報を整理し、次の仕事につなげる技術へと進化しています。
そんな音声認識ですが、実はその歴史は70年以上前にさかのぼります。
まだAIもスマートフォンもなかった時代、人の声を機械に理解させようとした研究者たちは、どんな技術を生み出してきたのでしょうか?
本記事では、音声認識研究の始まりから、生成AIと融合する現在までの歴史を、時系列で分かりやすく解説します。AI時代を支える「音声認識」が、どのように進化してきたのか。
その歩みを、振り返ってみましょう。
音声認識開発の先駆け(~1950年代)
70年の歴史がある音声認識ですが、実はその始まりは電話の歴史とも少し関係があります。
1876年、アレクサンダー・グラハム・ベルが電話を発明したことで、人の「声」を電気信号に変えて遠くへ届けられるようになりました。この技術を研究したのがベル研究所(Bell Labs)です。ベルシステム社の研究開発部門として設立されたベル研究所は、通信技術だけでなく、トランジスタやレーザーなど数々の技術革新を生み出した、世界有数の研究機関として知られています。
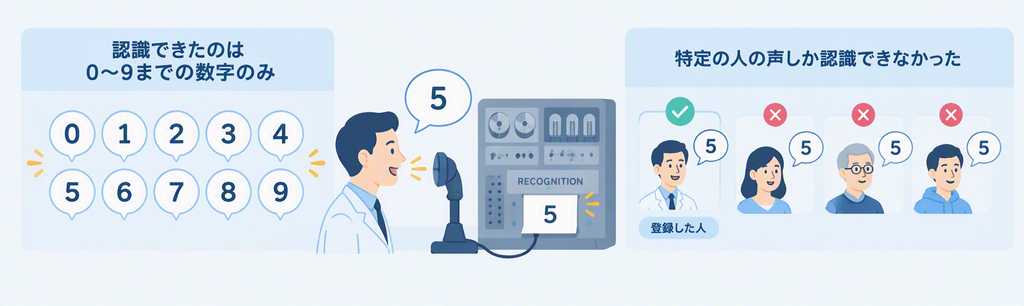
音声認識研究の先駆けとなったのは、1952年にこのベル研究所で開発された「Audrey」です。認識できたのは0〜9までの数字のみで、しかも特定の人の声しか認識できませんでした。それでも、「機械が人の言葉を理解する」という発想そのものが、当時としては画期的でした。ここから、現在の生成AIへとつながる音声認識70年の歴史が始まります。
第1世代:パターン照合の時代(1960年代)
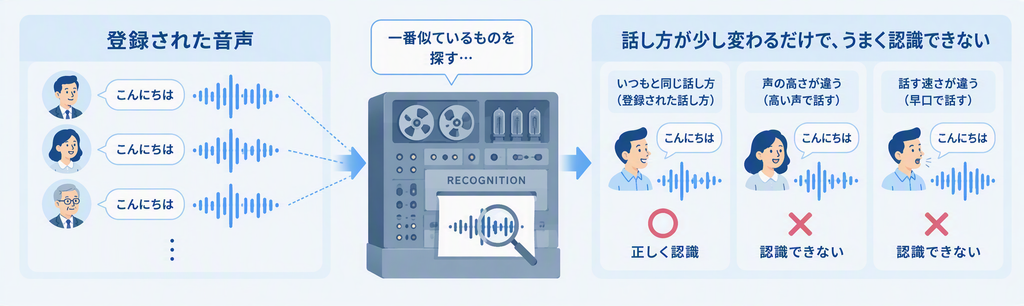
初期の音声認識は、登録された音声と実際に話した音を比べ、最も似たものを探す仕組みでした。
1962年にはIBMが「Shoebox」を発表し、数字だけでなく簡単な単語も認識できるようになりました。同じ頃、日本でも京都大学で単音節認識の研究が進められ、音声認識の基礎技術が少しずつ築かれていきます。
ただ、この頃の音声認識はまだ研究段階でした。
例えば同じ「こんにちは」でも、人によって声の高さも話す速さも違います。昨日と今日の自分ですら、体調や気分で話し方は変わります。そうした違いをコンピューターはうまく理解できず、少し話し方が変わるだけで認識できなくなることも珍しくありませんでした。
「人の声は思った以上に個人差が大きい。」
それが、研究者たちの最初の壁だったのです。
第2世代:DPマッチングという発想(1970〜80年代)
この課題を解決するために登場したのが、「DPマッチング(Dynamic Programming Matching)」という技術です。
少し難しく聞こえますが、考え方は意外とシンプルです。
例えば、「ありがとう」を早く話しても、ゆっくり話しても、私たちは同じ言葉だと分かります。
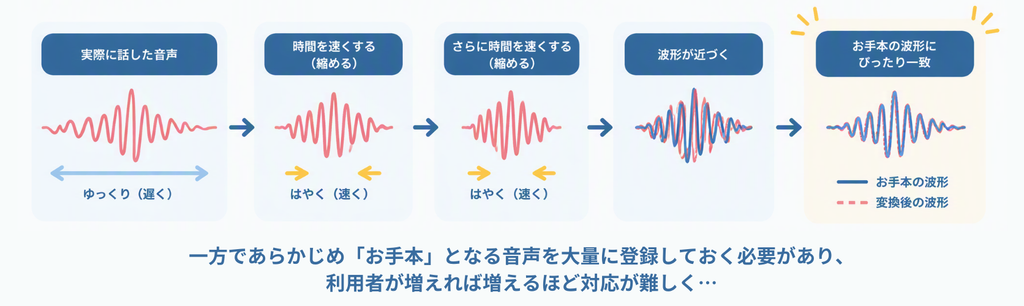
DPマッチングは、音声を時間方向に伸ばしたり縮めたりして比べることで、話す速さの違いに対応する技術です。
それまでのように単純に音の波形を比べるのではなく、「話すスピードが違っても同じ言葉」と判断できるようになったことで、音声認識は大きく前進しました。
一方で、根本的な課題は残っていました。
この方式では、あらかじめ「お手本」となる音声を大量に登録しておく必要があります。利用者が増えれば増えるほど、お手本も増やさなければならず、さまざまな人の話し方や方言、アクセントまで対応するのは現実的ではありませんでした。
つまり、「似ている音を探す」という発想だけでは限界が見え始めていたのです。
第3世代:統計モデルへの転換(1980〜2000年代)
音声認識が大きく飛躍したのは、この時代です。
それまでの音声認識は、「どのお手本に一番似ているか探す技術」から「最も可能性の高い言葉を予測する技術」へ変わりました。
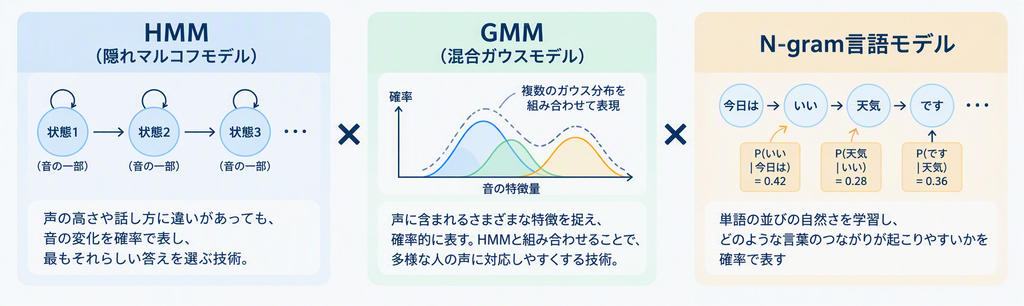
そこで登場したのが、HMM(隠れマルコフモデル)という統計モデルです。
声の高さや話し方に違いがあっても、音の変化を確率で表し、最もそれらしい答えを選ぶ技術です。
さらに、音の特徴を表現するGMM(混合ガウスモデル)や、文章の自然さを学習するN-gram言語モデルも組み合わさり、認識精度は飛躍的に向上しました。
これらの技術によって、音声認識は研究室の中だけでなく、実際の仕事でも使える技術へ近づきました。
日本でも音声認識の実用化が進み始め、1997年にはアドバンスト・メディアが創業。日本語音声認識エンジン「AmiVoice」の開発がスタートしました。
当時の課題は、単に日本語を文字にすることではありません。医療、コールセンター、議会、物流など、それぞれの現場には専門用語や独特の話し方があり、実際の業務で使えるレベルまで精度を高める必要がありました。
その後AmiVoiceは、日本語に特化した音声認識技術を磨きながら、こうした現場ごとの課題に取り組み、実用化を進めていきます。
第4世代:ニューラルネットワークの時代(2010年代〜)
2010年代に入ると、音声認識はもう一度、大きな転換期を迎えます。
その立役者となったのが、ディープラーニング(深層学習)です。「AI」という言葉が広く注目されたのも、この頃でした。
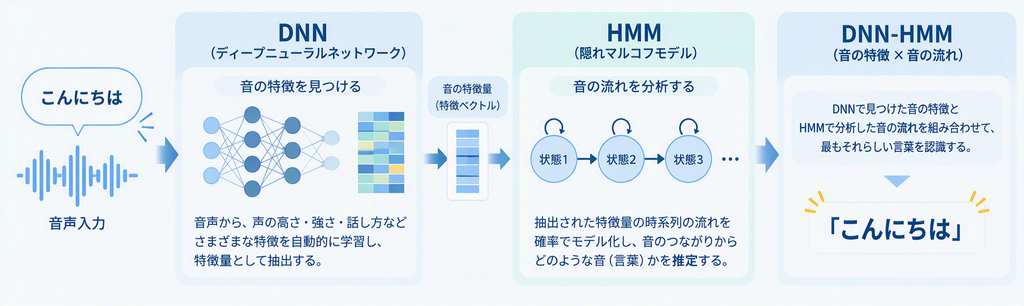
それまで使われていたHMMには、人によって異なる声の特徴を細かく見分けることに限界がありました。そこで、音の特徴を見つけるDNNと、音の流れを分析するHMMを組み合わせた「DNN-HMM」が登場します。
これにより、認識精度は大きく向上しました。
この進化を、多くの人が初めて実感したのが2011年です。AppleがiPhone 4Sに音声アシスタント「Siri」を搭載。スマートフォンに話しかける体験が身近になりました。
業務でも、カルテや議事録の作成、電話応対の文字起こし、物流現場での音声入力など、キーボードを使わずに情報を記録する働き方が広がっていきます。
第4.5世代:End-to-Endモデルの時代(2015年〜)
2015年前後からは、音声認識の仕組みそのものが再び変わり始めます。
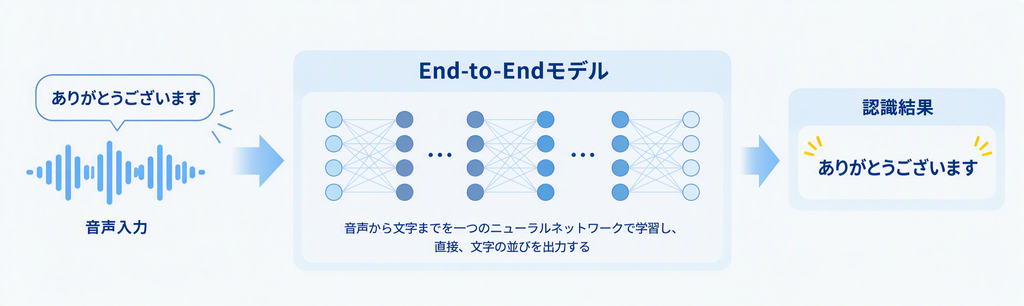
それまでの音声認識は、「音を分析する」「言葉を推測する」「文章として組み立てる」という複数の仕組みを組み合わせていました。
新たに登場したEnd-to-Endモデルは、その一連の処理をひとつのニューラルネットワークで学習してしまうという新しい考え方です。
最初はCTC※1やAttention※2といった手法が使われ、その後は生成AIでもおなじみのTransformer※3が採用されるようになります。
これにより、大量のデータから効率よく学習できるようになり、音声認識の精度はさらに向上しました。
AmiVoiceも、この技術の進化に合わせて音声認識APIを提供し、2023年にはTransformerを採用した新しいエンジンを実装しています。音声認識を自社製品だけでなく、さまざまなアプリケーションへ組み込める環境が整ったことで、開発者が音声認識を活用する場面も大きく広がりました。
※1 CTC:音声のどの部分がどの文字に当たるかを細かく指定しなくても、音声と文字の対応関係を学習できる仕組み。
※2 Attention:音声の中から、その時点で特に注目すべき部分を選びながら、次の文字を予測する仕組み。
※3 Transformer:Attentionを中心に使い、音声や文章に含まれる情報同士の関係をまとめて捉えるニューラルネットワークの仕組み。音声認識だけでなく、生成AI発展の土台にもなっている。
生成AIとの融合(2020年代〜現在)
そして2020年代に入り、音声認識は再び大きな転換期を迎えます。
そのきっかけとなったのが、ChatGPTをはじめとする生成AIの登場です。
これまでの音声認識にとって、基本的なゴールは「話した内容を正確に文字にすること」でした。しかし、生成AIと組み合わせることで、その先まで処理できるようになりました。
文字になった情報を生成AIが要約し、議事録を作成したり、顧客対応の内容を整理したり、次に取るべきアクションを提案したりすることまで、一連の流れとして行われるようになりました。
例えば会議では、録音データから議事録が自動で作成されます。コールセンターでは、お客様との会話をリアルタイムで文字化し、その内容をもとにAIが回答候補を提示したり、応対記録を自動作成したりする仕組みも広がっています。
つまり、音声認識は「ゴール」ではなく、「生成AIへ正しい情報を渡す入口」へと役割が変わりつつあるのです。
おわりに
70年以上前、音声認識は数字を10個認識するだけの技術でした。
そこから、パターン照合、統計モデル、ディープラーニング、End-to-Endモデルへと進化を重ね、今では私たちの生活や仕事を支えるインフラの一つになっています。
そして現在、注目を集めているのは生成AIです。しかし、その生成AIが力を発揮するためには、入力となる情報が正確であることが欠かせません。
音声認識の歴史を振り返ると、「認識率を上げる競争」が注目されがちです。しかし実際には、「医療の専門用語を聞き取れるか」「騒がしい工場でも使えるか」「電話を話しながらリアルタイムで文字にできるか」といった、現場ごとの課題を一つひとつ解決することで、実用化が進んできたともいえるでしょう。
こうした課題は、70年前と比べれば大きく進歩したものの、業種や現場ごとに今も工夫が続けられています。生成AIの時代だからこそ、「正しく聞き取る」という音声認識の価値は、これまで以上に重要になっているのかもしれません。
そう考えると、音声認識の進化は、声を文字にする技術の進化ではありませんでした。人間がコンピューターと自然に対話するためのインターフェースの進化だったとも言えるでしょう。
音声認識の歴史は、まだ終わりではありません。これからも新たな進化が続いていくはずです。
| 年 | 出来事 |
|---|---|
| 1952年 | アメリカのベル研究所が、数字音声認識システム「Audrey」を発表 |
| 1962年 | IBMが音声認識計算機「Shoebox」を発表 京都大学が音声タイプライターを開発 |
| 1970年代 | 日本・ソ連で「DPマッチング法」が開発され、単語の連続認識が可能に |
| 1980年代 | IBM やカーネギーメロン大学が「隠れマルコフモデル」を応用し、統計データに基づく音声認識を開発 |
| 1997年 | 国内の音声認識専業ベンダーとしてアドバンスト・メディアが創業 |
| 2011年 | AppleがスマートフォンにSiriを搭載 |
| 2015年 | 「End-to-End型」の音声認識の研究が本格化 |
| 2017年 | 機械翻訳向けに Transformer が登場(のちに音声認識や生成AIにも使われる) Google・Amazon が日本で発売、Apple が HomePod を発表 |
| 2022年 | OpenAIが多言語の音声認識が可能なモデル「Whisper」を公開 |
| 2023年 | GPT-4の登場により、音声認識結果を要約・分析・生成AIと連携する活用が本格化 |
| 2025年 | AIエージェントの普及が進み、音声認識は業務の実行まで担う技術へ進化 |
関連記事
参考
河原達也(2018年)「音声認識技術の変遷と最先端」『日本音響学会誌第74巻07号 』
株式会社アドバンスト・メディア「音声認識の歴史」 https://www.advanced-media.co.jp/corporate/history/
この記事を書いた人
-

みあはら
音声認識の会社に入社し営業をして、今はマーケ(勉強中)。大河ドラマを見るのが好きです。
よく見られている記事
新着記事
-
音声認識70年史。技術はどのように進化してきたのか
-
kintoneでもAmiVoice -筋斗雲と順風耳-
-
生成AI向けにAmiVoice APIマニュアルを整理 -Markdownとllms.txtの提供-
カテゴリ一覧
アーカイブ