生成AI向けにAmiVoice APIマニュアルを整理 -Markdownとllms.txtの提供-
現在、生成AIにコードを書かせる開発が広がっていますが、モデルの知識だけで動かすと、存在しないパラメータやエンドポイントが混ざることがしばしばあります。誤りを減らすには、最新の公式ドキュメントを参照させるのが有効です。
生成AIもHTMLのドキュメントは読めますが、トップページを与えても必要な情報にたどりつけなかったり、本文以外のタグやナビゲーションもトークンを消費します。今まで、AmiVoice APIのドキュメントは、人がブラウザで読むためのHTMLだけを提供していましたが、AIが参照しやすい形式でも配信することにしました。
きっかけは、Zennfes Spring 2026で見た「駅すぱあとAPI」のライトニングトークです。API仕様の入口にllms.txtを置き、IssueやPull RequestはGitHub MCP、作業ルールはAGENTS.mdを通じて生成AIに参照させていました。生成AIに仕事を任せる前に、AIが自ら必要な情報を取得できる環境を整えることを実践し、成果につなげていた点が特に印象に残りました。このようなAIを使った開発ワークフローはAmiVoice APIの利用者にも期待されていると考え、その土台としてまずは公式ドキュメントの配信方法を整えました。
この記事では、生成AIが公式ドキュメントを参照しやすくするために行った3つの対応について、実装と効果をあわせて紹介します。
対応したこと
行ったのは次の3つです。
- 各ページのMarkdown版を作り、
Accept: text/markdownが指定されたら返す - 最初に読むべきページをまとめた
llms.txtを置く - Markdown版や
llms.txtを示すHTTPLinkヘッダーを付ける
あわせてrobots.txtを追加し、クロールを制限しない方針とsitemap.xmlの場所を明示しました。もともとこのサイトにはrobots.txtを置いていませんでした。robots.txtが無い場合もクロールは許可されるため、今回の追加で公開範囲は変わっていません。
システム構成
AmiVoice APIのドキュメントサイト(docs.amivoice.com)は、DocusaurusというMetaが開発するオープンソースのドキュメントサイト生成ツールを使って構築しています。
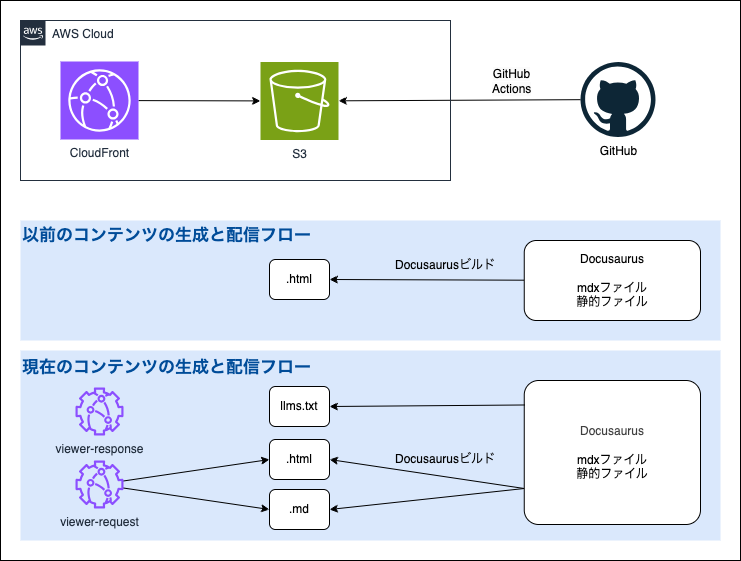
以前はDocusaurus上のMDX(Reactコンポーネントを使える拡張されたMarkdown)として記述された原稿を、GitHub ActionsでビルドしてHTMLを生成し、Amazon S3へ配置していました。クライアントからはAmazon CloudFrontを通じてファイルにアクセスします。
現在のコンテンツの生成と配信フローについては以下に詳しく説明します。
1. Markdown版を提供する
ステップ1:ビルド時にMarkdown版を作る
コンテンツは前述のMDXで記述されており、HTMLに変換して公開しています。今回、MDX固有のReactコンポーネントやページ先頭のメタ情報(フロントマター)から公開しても意味のない情報を削除して、HTMLと同じ内容のMarkdownを各ページに作成することにしました。URLの末尾に拡張子.mdをつけてアクセスすることでMarkdown版を取得できるようにしました。
HTMLコンテンツ:
https://docs.amivoice.com/amivoice-api/manual/getting-started
Markdownコンテンツ:
https://docs.amivoice.com/amivoice-api/manual/getting-started.md
トップページだけは元になるMarkdownが無かったため、表示しているカードの情報からindex.mdを作りました。
ステップ2:AcceptヘッダーでHTMLとMarkdownを出し分ける
AIエージェントで採用が進みつつあるAccept: text/markdownヘッダーに対応しました。
例えば、次のようにAcceptヘッダーを付けた場合、HTMLではなくMarkdownを返します。
curl -H "Accept: text/markdown" \
     https://docs.amivoice.com/amivoice-api/manual/getting-started
これには、CloudFront Functionsのviewer-requestを使い、このヘッダーがある場合に、内部のリクエスト先を.mdへ書き換えています。
この方式に対応しているAIエージェントはまだ一部です。Cloudflareの2026年4月の記事で紹介されている調査では、7つのエージェントのうち、Accept: text/markdownを既定で送ったのはClaude Code、OpenCode、Cursorの3つでした。同調査では配信側の対応もまだ3.9%にとどまっているそうです。
2. llms.txtを置く
生成AIにドキュメントのトップページのURLを与えてコードを書かせたり、調査をさせたりしても必要なページにたどり着けずに誤った回答をしてしまうケースがあります。そのため生成AIがまず読むべきファイルとしてllms.txtをルートに置くことが提案されています。AmiVoice APIでも以下のURLで公開しました。
https://docs.amivoice.com/llms.txtこのファイルは自動生成せず、インタフェースの選び方、実装、レスポンスの確認、運用など、先に読んでほしいページを選び、なるべく生成AIがたどり着きやすいように短い説明を付けたリンク集になっています。リンク先は各ページのMarkdown版としています。
ただ、このllms.txtもIETFやW3Cの標準ではなく、すべての生成AIが自動的に探すわけではありません。Googleも、Google Searchではllms.txtを使わず、検索順位には影響しないと説明されています。現時点では、人間がこのURLを明示的に生成AIに与えることが主な利用方法と考えています。
3. Linkヘッダーで関連するファイルを示す
HTMLのレスポンスに、関連するMarkdown版やllms.txtをHTTP Linkヘッダーで示すことにしました。これはCloudflareやドキュメントプラットフォーム Mintlify、クラウドプラットフォームVercelなどが取り入れている方法で、生成AI向けのドキュメントが存在することを示すことができます。
トップページではllms.txtを案内します。
Link: </llms.txt>; rel="describedby"; type="text/markdown"各ドキュメントページでは、同じ内容の別形式としてMarkdown版を示します。
Link: </amivoice-api/manual/getting-started.md>; rel="alternate"; type="text/markdown"Linkヘッダーを付けるのは、Markdown版が実在するHTMLページだけとし、既存のLinkヘッダーがある場合は上書きせず、同じ値も重複させないようにしました。Linkヘッダーの付与はCloudFrontの viewer-response で実装しています。
ただ、生成AIがドキュメントを発見するための仕組みはまだ統一されていません。LinkヘッダーはRFC 8288で標準化されていますが、生成AI向けの情報をどう提供するのかは決まっていません。AmiVoice APIでは、独自の関係名やヘッダーは作らず、IANAに登録されているalternateとdescribedbyを使う方式を採用しました。トップページからllms.txtへはdescribedby、各ドキュメントのHTMLから同じ内容のMarkdown版へはalternateで関連付けます。今後、エージェント側の対応や仕様の標準化が進んだ場合は、必要に応じて見直します。
効果
MarkdownはHTMLの7.5%
ドキュメントサイトのHTMLには本文だけでなく、ナビゲーション、サイドバー、ヘッダー、フッター、スタイル(CSS)、JavaScriptも含まれ、これらも生成AIのトークンを消費してしまいます。Markdownの効果としてトークン消費を抑える効果がどの程度あるのか、元のHTMLからMarkdown版がどれくらい小さくなったのかを調べました。
計測には、OpenAIが公開しているBPEトークナイザーtiktokenを使いました。エンコーディングは、GPT-4oで使われるo200k_baseです。各ページについて、次の3種類の文字列を同じエンコーディングへ入力しました。
- 通常のリクエストで取得したHTML全体
- HTMLをパースし、タグを除いて残ったテキスト
- 同じURLへ
Accept: text/markdownを付けて取得したMarkdown
カウント部分は次のとおりです。encode()が返すトークンIDの個数を、そのページのトークン数としました。トークナイザーが異なれば絶対値も変わりますので、絶対値は参考程度にしてください。
import tiktoken
encoding = tiktoken.get_encoding("o200k_base")
token_count = len(encoding.encode(text))
2026年7月時点で公開していたマニュアルとリファレンス、合計123ページでした。それぞれのトークン数は以下のとおりでした。
| 測り方 | トークン合計 | 生HTML比 |
|---|---|---|
| 配信されたHTML | 約302万 | 100% |
| HTMLからタグだけを除去したテキスト | 約114万 | 37.7% |
| Markdown版 | 約22.7万 | 7.5% |
Markdown版は、生のHTMLの約13分の1でした。ファイルサイズでも、HTMLの合計5.73MBに対してMarkdownは0.82MBです。
思ったよりも大きな差がありました。Markdown版を使うことで、生成AIのトークン消費を減らすことができるのは確かなようです。
71本を調査し、6記事で11件の仕様差異を確認
Zennのコンテスト「音声認識AmiVoice APIと生成AIで作る音声体験」の応募記事71本を対象に、生成AIに仕様についての誤解がないかどうかを調べてみました。llms.txtを起点にして、生成AIに誤りと思われる箇所を抽出させ、最終的に人が公式仕様と比べました。利用したモデルはClaude Fable 5です。
まず、多くの記事は正確でした。ただ、6記事に11件の仕様差異が見つかりました。特に多かったのは、WebSocketのコマンド体系と、話者ダイアライゼーションで使えるインタフェースやパラメータの取り違えです。
仕様に差異が多かった箇所は、生成AIや利用者がドキュメントを検索して該当する仕様へたどり着きにくかった可能性があります。これらはドキュメントの改善点として受け取って、対応を進めています。また、記事を書いていただいた投稿者の方々には、指摘内容を共有し、記事の修正もお願いしました。
今回の調査によって、llms.txtの記述の不備も見つけることができました。ドキュメントには明記されているのに、仕様の正誤が判断できず、人間に確認を依頼してしまったケースです。これらについてはllms.txtの記述を改善しました。
使い方
AIエージェントが対応すると人間が使い方を意識する必要はなくなるのですが、AIエージェントの多くはまだ、Accept: text/markdownやllms.txtを使うわけではありません。そこで、利用者が明示的にMarkdownコンテンツやllms.txtを利用する方法を紹介します。
以下のように生成AIには、llms.txtのURLと、公式ドキュメントを根拠にするよう指示します。
https://docs.amivoice.com/llms.txt を起点として、 リンク先のAmiVoice API公式ドキュメント
を参照してください。

{{ここに指示を書きます}}

仕様を推測せず、参照した公式ドキュメントのURLを示してください。詳しい使い方は、マニュアルの「生成AIを利用した開発」にもまとめています。
今回は見送ったもの
対応範囲を考える際には、サイトのAIエージェント対応状況を確認できるisitagentready.comが非常に参考になりました。基本的にすべて対応するつもりで始めたのですが、DNS-AID、Content Signals、Web Bot Auth、MCPサーバーカード、Agent Skills、WebMCP、x402などには、対応しませんでした。これらはまだ提案段階で、かつ、手間がかかるものだったり、静的なAPIドキュメントの配信という今回の目的から外れていたりするためです。
今後、必要になった時点で検討しようと考えています。
まとめ
音声の内容を要約、検索、分類したり、ほかのシステムと連携したりするには、まず正確で再利用しやすいテキストに変換する工程が重要です。生成AIには音声を直接扱えるモデルもありますが、日本語の業務音声やリアルタイム処理、大量の音声を扱う用途では、音声認識を専門のエンジンに任せ、その結果を生成AIが解釈・加工する役割分担のほうが、精度・処理時間・コストを管理しやすいと考えています。
こうした構成では、コードを書くのも仕様を調べるのも生成AIという場面が今後ますます増えていきます。人がブラウザでドキュメントを読む機会は残る一方で、生成AI経由で参照される割合は確実に高まっていくはずです。生成AIが公式ドキュメントへ正しくたどり着ける環境を整えることは、APIベンダーとして優先度の高い取り組みだと考え、今回の対応を行いました。
今後も実際の利用結果をもとに、生成AIが利用しやすいドキュメントとサービスへ改善を続けていきますので、ご期待ください。
参考リンク
- Is It Agent Ready?
- llms.txtの提案仕様 — llmstxt.org
- AIに作業委譲できる開発環境の作り方 〜Zennfes Spring 2026 LT登壇〜 — 駅すぱあとAPI
- llms.txtのURLを1行渡したら、AIが仕様をたどりながらウェブアプリを作ってくれた話 — 駅すぱあとAPI
- AI Meets API Docs: The Why Behind /llms.txt — ReadMe
- Announcing Twilio Docs Support for llms.txt and Markdown — Twilio
- Improved agent experience with llms.txt and content negotiation — Mintlify
- Introducing Markdown for Agents — Cloudflare
- Markdown for Agents — Cloudflare Developers
- Google Searchにおける生成AI向け最適化のガイド — Google Search Central
- RFC 8288: Web Linking — IETF
- RFC 7763: The text/markdown Media Type — IETF
- robots.txtの作成方法 — Google Search Central
- CloudFront Functions — Amazon Web Services
- tiktoken — OpenAI
よく見られている記事
新着記事
-
生成AI向けにAmiVoice APIマニュアルを整理 -Markdownとllms.txtの提供-
-
音声認識APIの選び方。失敗しないための4つの比較ポイント
-
導入前に知っておきたい、日本語音声認識の精度の話
カテゴリ一覧
アーカイブ